Dieser Artikel beschäftigt sich mit der Vorlesung „Neuronale Netze“ am KIT. Er dient als Prüfungsvorbereitung. Ich habe die Vorlesungen bei Herrn Prof. Dr. Alexander Waibel im Sommersemester 2015 gehört.
When to use which objective function (cross entropy, MSE); Backpropagation; Weight initialization; Regularization (L2 weight decay, dropout); Time Delay NN; Recurrent Networks; Applications (Speech Recognition, Computer Vision)
NN01-Intro.pdf
Human Brain vs. Computer (Processing/Processors, Accuracy, Speed, Hardware, Design)
Aufbau eines biologischen Neurons (vgl. Wikipedia)
NN02-Classification.pdf
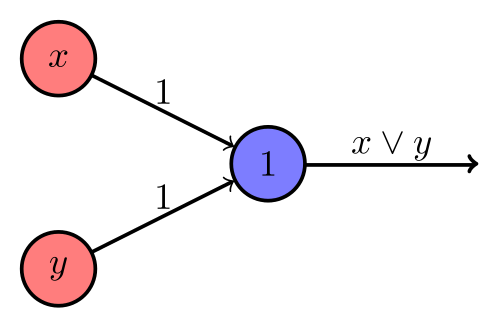
Rosenblatt-Perceptron which realizes logical or
McCulloch-Pitts Neuron (weights, bias, activation function is step function)
Given events $A_1$, $A_2$ and $B$, Bayes' rule states that the conditional odds of $A_1:A_2$ given $B$ are equal to the marginal odds of $A_1:A_2$ multiplied by the Bayes factor or likelihood ratio $\Lambda$:
$$O(A_1:A_2|B) = \Lambda(A_1:A_2|B) \cdot O(A_1:A_2) ,$$
where
$$\Lambda(A_1:A_2|B) = \frac{P(B|A_1)}{P(B|A_2)}.$$
Parametrischer Klassifizierer
Ein Klassifizierer heißt parametrisch, wenn er eine Wahrscheinlichkeitsverteilungsannahme macht.
Naiver Bayes-Klassifikator
Ein Klassifizierer heißt naiver Bayes-Klassifikator, wenn er den
Satz von Bayes unter der naiven Annahme der Unabhängigkeit der Features
benutzt.
Normalverteilung
Eine stetige Zufallsvariable $X$ mit der Wahrscheinlichkeitsdichte
$f\colon\mathbb{R}\to\mathbb{R}$, gegeben durch
$f(x) = \frac {1}{\sigma\sqrt{2\pi}} e^{-\frac {1}{2} \left(\frac{x-\mu}{\sigma}\right)^2}$
heißt $\mathcal N\left(\mu, \sigma^2\right)$-verteilt, normalverteilt
mit dem Erwartungswert $\mu$ und Varianz $\sigma^2$.
Eine $p$-dimensionale reelle Zufallsvariable $X$ ist normalverteilt
mit Erwartungswertvektor $\mu$ und (positiv definiter) Kovarianzmatrix
$\Sigma$, wenn sie eine Dichtefunktion der Form
$$f_X(x)=\frac{1}{ \sqrt{(2\pi)^p \det(\Sigma)} } \exp \left( -\frac{1}{2}(x-\mu)^{T}\Sigma^{-1}(x-\mu) \right)$$
besitzt. Man schreibt
$$X\sim \mathcal N_p(\mu, \Sigma).$$
Gauß'scher Klassifizierer
Ein (naiver) Bayes-Klassifikator, welcher von normalverteilten Daten
ausgeht, heißt Gauß'scher Klassifizierer.
Die Hauptkomponentenanalyse ist ein Verfahren zur
Dimensionalitätsreduktion von ungelabelten Daten im $\mathbb{R}^n$.
Sie projiziert die Daten auf denjenigen $d$-dimensionalen (affinen)
Unterraum des $\mathbb{R}^n$, der den durch die Projektion
stattfindenden Datenverlust minimal hält.
Dabei ist $d \in \{1, \dots, n\}$ beliebig wählbar.
Die Transformation der Daten $X$ findet durch eine Matrixmultiplikation
$Y = P^T \cdot X$ statt. Die Matrix $P$ besteht aus den Eigenvektoren
zu den $d$ größten Eigenwerten der Kovarianzmatrix der Features $X$:
$P = (v_1, \dots, v_d)$ mit
$\lambda_j v_j = C_X v_j$ für $j=1,\dots,d$
Außerdem gilt: $C_X = \frac{1}{N-1} X X^T$ (für zentrierte Daten $X$ mit
$N$ Datenpunkten als Spalten)
V03: LVQ
Slide name: V03_2015-04-21_LVQ.pdf
k-Means
Fuzzy k-Means
Vector Quantization (VQ) is an unsupervised clustering algorithm
Learning Vector Quantization is supervised.
V04: Perceptron
Slide name: V04_2015-04-28_Perceptron.pdf
McCulloch–Pitts (MCP) Neuron
Ein MCP-Neuron ist ein Algorithmus zur binären Klassifizierung. Er hat
$m+1$ Inputs $x_i \in \{0, 1\}$ (mit $m \in \mathbb{N}_{> 0}$). Davon
ist der erste (nullte) konstant gleich Eins und wird Bias genannt.
Jeder Input wird mit einem Gewicht $w_i \in \mathbb{R}$ multipliziert,
alle gewichteten Inputs werden addiert und schließlich wird die
Stufenfunktion
$\varphi(x) = \begin{cases}1 &\text{falls } x > 0\\0 &\text{sonst} \end{cases}$
angewendet.
Man lernt mit MCP Neuronen, indem man
$$\Delta w = \eta \delta x$$
$$w \gets w + \Delta w$$
berechnet, wobei $\eta \in (0, 1)$ die Lernrate ist, $x$ ein Trainingsdatum
und $\delta = y_{\text{target}} - y$ die Abweichung vom gewünschten
Ergebnis ist. Diese Regel wird auch Perceptron Learning Rule genannt.
Rosenblatt-Perzeptron
Wie das McCulloch–Pitts (MCP) Neuron, nur ist $x_i \in \mathbb{R}$ und
ein Lernalgorithmus ist gegeben. Dieser addiert den mit
$\eta \in (0, 1)$ gewichteten, fehlklassifizierten Vektor auf die
Gewichte $w_i$. $\eta$ heißt die Lernrate.
Man lernt mit MCP Neuronen, indem man
$$\Delta w = \eta \delta x$$
$$w \gets w + \Delta w$$
berechnet, wobei $\eta \in (0, 1)$ die Lernrate ist, $x$ ein Trainingsdatum
und $\delta = - \frac{\partial E}{\partial w}$ der Gradient auf der
Fehleroberfläche in Abhängigkeit von den Gewichten ist. Es wird also
Gradient descent verwendet.
Pocket Perceptron Algorithm
Ein Lernalgorithmus für ein Rosenblatt-Perzeptron. Dieser konvergiert zu
Gewichten, welche die wenigsten Beispiele falsch klassifizieren.
Sigmoid-Funktion
$\varphi(x) = \frac{1}{1+e^{-x}}$
Softmax-Funktion
$\varphi(a_i) = \frac{e^{a_i}}{\sum_{k} e^{a_k}}$ wobei $a_i$ die
Aktivierung des $i$-ten Neurons derselben Schicht ist.
Perzeptron / Logistic Neuron
MSE + Sigmoid activation function
Fakten:
Das Rosenblatt-Perzeptron findet eine lineare Trenngrenze, wenn sie
existiert.
Probleme des Rosenblatt-Perzeptrons:
Nicht-linear trennbare Daten wie z.B. das XOR-Problem
Nicht-trennbare Daten
Wahl der Lernrate und der Startgewichte
Aufbau eines biologischen Neurons (Axon, Dendriten, Zellkörper, Ranviersche
Schnürringe, Synapsen)
Glia-Zellen
V05: Features
Slide name: V05_2015-04-29_Features.pdf
Rectified Linear Unit (ReLU)
$\varphi(x) = \max(0, x)$
Leaky ReLU
$\varphi(x) = \max(0.01x, x)$
Softplus
$\varphi(x) = \log(1 + e^x)$
Feed Forward Neural Network
A Feed Forward Neural Network is a learning algorithm which takes
a fixed-size input feature vector, applies various matrix multiplications
and point-wise non-linear functions to obtain a fixed-size output
vector.
Multilayer Perceptron
A Multilayer Perceptron is a special type of Feed Forward Neural Network.
It consists of fully connected layers only.
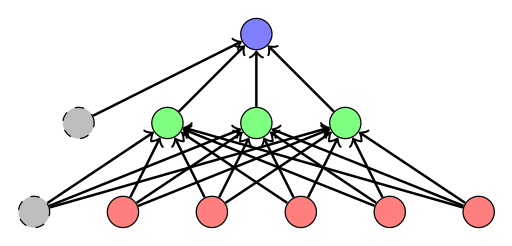
Figure 1: Draft of a multilayer Perceptron (MLP). The bias units are grey, the input units are red, the hidden units are green and the output unit is blue. The edges are directed from input, to hidden, to output and from the bias to hidden / output.
Es seien $a, b$ Zeichenketten, $|a|$ die Länge der Zeichenkette $a$
und $\delta_{a_i \neq b_j}$ genau dann 1, wenn das $i$-te Zeichen von
$a$ und das $j$-te Zeichen von $b$ sich unterscheiden.
Dann heißt $d_L(a, b)$ die Levenshtein-Distanz:
$$d_L(a,b) := \text{lev}_{a,b}(|a|, |b|)$$
$$\text{lev}_{a,b}(i, j) = \begin{cases}\max(i,j) &\text{falls } \min(i,j) = 0,\\
\min \begin{cases}\text{lev}_{a,b}(i-1,j)+1\\
\text{lev}_{a,b}(i,j-1)+1\\
\text{lev}_{a,b}(i-1,j-1)+\delta_{(a_i \neq b_j)}\\\end{cases} &\text{sonst}\end{cases}$$
Fragen:
Welche Feed Forward Neuronalen Netze existieren, die keine Multilayer
Perceptronen sind?
→ CNNs, TDNNs, SOMs.
Welche Skalentypen gibt es für Merkmale (Features)?
Nominale Merkmale: Nur Gleichheit kann überprüft werden
Ordinale Merkmale: Es existiert eine "kleiner gleich"-Relation
Intervallskalierte Merkmale:
Die Differenz der Merkmale hat eine Semantik
Es existiert jedoch kein "wirklicher" Nullpunkt
Verhältnisskalierte Merkmale: Wie Intervallskaliert, aber mit absolutem
Nullpunkt.
$$E_{-x} = - \sum_{k}[t_k^x \log(o_k^x) + (1-t_k^x) \log (1- o_k^x)]$$
wobei $x$ der Feature-Vektor ist, $k$ ein Neuron des letzten
Layers, $t$ der wahre Wert (d.h. der gewünschte Output),
$o$ der tatsächliche Output ist.
Ein Autoencoder ist ein neuronales Netz, welches darauf trainiert wird,
die Input-Daten am Output wieder zu replizieren.
Bottleneck Features
Unter Bottleneck-Features versteht man eine Schicht in einem
neuronalen Netz, welche wesentlich kleiner ist als die vorhergehende
und nachfolgende Schicht.
Die Kullback-Leibler-Divergenz ist ein Maß für die Unterschiedlichkeit
zweier Wahrscheinlichkeitsverteilungen $P, Q$. Für
diskrete Verteilungen ist sie definiert als:
$$KL(P||Q) := \sum_{x \in X} P(x) \cdot \log \frac{P(x)}{Q(x)}$$
Denoising Autoencoder
Ein Autoencoder, welcher trainiert wird, Rauschen zu entfernen.
Fakten:
Eine lineare Aktivierungsfunktion wird in einer Repräsentation im
Bottleneck-Feature resultieren, die PCA ähnelt.
Fehlerfunktion:
CE bei binären Ausgaben (d.h. Input-Features)
MSE bei reellen Ausgaben (d.h. Input-Features)
Fragen:
Wie muss man die Grafik zu Stacked Denoising Autoencodern verstehen?
V08: Deep Learning
Slide name: V08_2015-05-13_Deep_Learning.pdf
Deep Neural Networks
Neural Networks with at least two hidden layers with nonlinear
activation functions.
Hyperparameter
Hyperparameter $\theta$ eines neuronalen Netzes sind Parameter,
welche nicht gelernt werden.
Learning Rate Scheduling
Start with a learning rate $\eta$ and reduce it while training.
RProp is a learning rate scheduling method which is only based on the
sign of the gradient. It increases the learning rate when the sign of
the gradient doesn't change and decreases or resets it when the sign of the
gradient changes. Rprop has its own learning rate for every single
weight.
$$\eta_{tij} = \frac{\eta_0}{\sqrt{1 + \sum_k {(\frac{\partial E^{t-k}}{\partial w_{ij}})}^2}}$$
where $\eta_0$ is an initial learning rate, $t$ is the epoch, $i,j$ refer to neurons.
Newbob Scheduling
Newbob scheduling is a combination of exponential decay learning rate
scheduling and performance scheduling. It starts with a learning rate
$\eta_0$. When the validation error stops decreasing, switch to
exponentially decaying learning rate. Terminate when the validation
error stops decreasing again.
Cross Entropy Error function (CE)
$$E_{CE}(w) = - \sum_{x \in X} \sum_{k} [t_k^x \log(o_k^x) + (1-t_k^x) \log(1-o_k^x)]$$
where $w$ is the weight vector, $X$ is the set of training
examples (feature vectors),
$t_k^x = \begin{cases}1 &\text{if } x \text{ is of class }k\\0&\text{otherwise}\end{cases}$
and $o_k^x$ is the output at neuron $k$ of the network for the
feature vector $x$.
Mean Squared Error function (MSE)
$$E_{MSE}(w) = \frac{1}{2}\sum_{x \in X} \sum_{k} (t_k^x - o_k^x)^2$$
where $w$ is the weight vector, $X$ is the set of training
examples (feature vectors), $k$ is the range of output neurons,
$t_k^x = \begin{cases}1 &\text{if } x \text{ is of class }k\\0&\text{otherwise}\end{cases}$ and $o_k^x$ is the output
at neuron $k$ of the network for the feature vector $x$.
Convolutional Neural Networks (CNNs)
Feed-Forward Neuronale Netze, welche durch geteilte Gewichte (weight
sharing) grafische Filter lernen. CNNs sind aktuell in der Computer
Vision Stand der Technik.
Time-Delay Neural Networks (TDNNs)
TDNNs wenden wie CNNs weight sharing an, um Filter zu lernen. Sie
werden in der ASR
verwendet und lernen auch Filter. Allerdings wird hier über die Zeit
hinweg gefaltet.
Eine optimale Strategie wird mit \(\pi^*\) bezeichnet.
Fragen:
Was bedeutet es, wenn in einem MDP der Diskontierungsfaktor
\(\gamma = 0\)
ist?
→ Nur der aktuelle Reward ist wichtig. Effektiv nimmt der Agent immer
das nächste Feld, welches den höchsten Reward bietet (bzw. die Aktion, die
den größten 1-Aktion Erwartungswert liefert).
Was bedeutet es, wenn in einem MDP der Diskontierungsfaktor
\(\gamma = 1\)
ist?
→ Der Agent versucht die Summe der Belohnungen insgesamt zu maximieren.
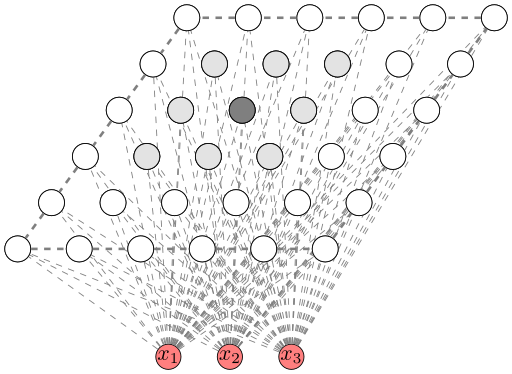
SOMs sind eine Art von Neuronalen Netzen. Die Neuronen von SOMs sind
auf einem Gitter angeordnet. Es gibt nur zwei Schichten: Die Input-Neuronen
und die Neuronen auf dem Gitter. Jedes Input-Neuron ist mit jedem Neuron
auf dem Gitter verbunden.
Figure 2: Draft of a self-organizing map (SOM).
Training:
Initialisierung: Die Gewichte
$w_{ji}$ vom
$i$-ten Input-Neuron ($i = 1, \dots, n$) zum Neuron
$j$ auf dem Gitter werden zufällig
initialisiert.
Sampling: Nimm ein zufälliges Beispiel
$x$ der Trainingsdaten.
Matching: Finde das Neuron
$j_{\text{min}}$, für das die Gewichte
dem Input am ähnlichsten sind:
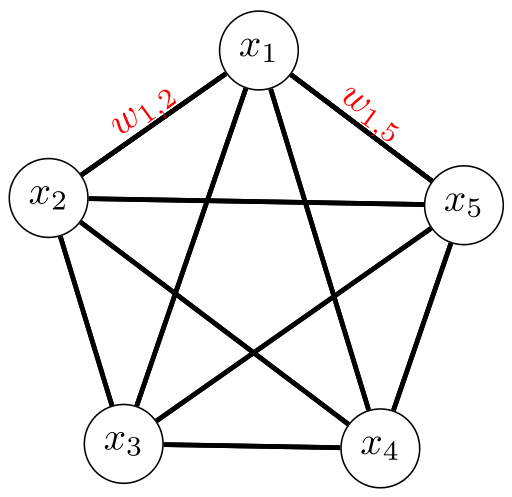
Ein Hopfield-Netz besteht nur aus einer Schicht von McCulloch-Pitts
Neuronen. Jedes Neuron ist mit jedem anderen Neuron (also nicht sich
selbst) und allen Inputs verbunden. Die Schicht funktioniert
gleichzeitig als Ein- und Ausgabeschicht.
Hopfield-Netze werden in einem einzigen Durchgang trainiert. Dabei wird
auf das Gewicht von Neuron $i$ zu Neuron $j$ + 1 addiert, wenn
die Bits $i$ und $j$ des Trainingsmusters gleich sind. Falls das nicht der Fall
ist, wird von dem Gewicht 1 subtrahiert:
$$w_{ij} = \sum_{p} (2 a^{(i)}_p - 1) \cdot (2 a^{(j)}_p - 1)$$
Jedes Gewicht ist zum Start des Trainings 0. Das Training ist also
einfach nur ein Zählen, wie häufig die Stellen übereinstimmen.
Figure 3: Draft of a Hopfield network. Every node is an input node. The McCulloch-Pitts nodes are updated asynchronously. When the state of the node doesn't change any more, they contain the output of the network. Learned are the weights between the nodes.
Boltzmann-Maschinen sind
stochastische neuronale Netzwerke, welche durch beliebige ungerichtete
Graphen repräsentiert werden können. Die Neuronen sind binär; sie
feuern also entweder oder nicht. Es gibt insbesondere keine
Unterschiede in der Stärke, mit der sie feuern.
Siehe auch: Scholarpedia
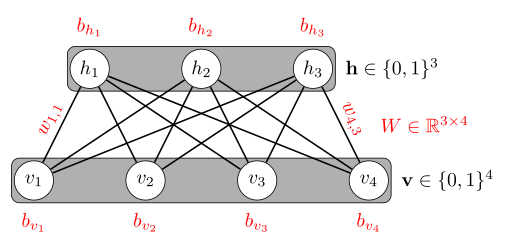
Eine RBM ist ein neuronales Netz mit nur einem Hidden Layer.
Es ist gleichzeitig ein Spezialfall von
MRFs.
Im Gegensatz zur Boltzmann-Maschine muss die Restricted Boltzmann-Machine
(RBM) aus einem bipartiten Graphen bestehen. Dies erlaubt ein effizienteres
Trainingsverfahren (Contrastive Divergence).
Die Energie des Netzwerkes ist
$$E = - \sum_{i < j} w_{ij} s_i s_j - \sum_i b_i s_i$$
wobei $s_i, s_j$ die binären Zustände der Knoten $i, j$ sind. Der
Name "Boltzmann" kommt von dieser Energie (man kann den Netzwerkzuständen
Wahrscheinlichkeiten zuweisen, die direkt proportional zu $e^{-E}$
sind).
Figure 4: Draft of an RBM. The learned parameters are red.
Es werden keine Verbindungen zwischen den Hidden Units erlaubt (daher das "restricted" - Quelle: Hinton, 2015).
Contrastive Divergence (CD, CD-$k$, siehe YouTube Video, 2 von Hugo Larochelle)
Contrastive Divergence ist ein Trainingsalgorithmus für RBMs.
Ein Hyperparameter ist $k \in \mathbb{N}$.
Er geht wie folgt vor:
Lege den Trainingsvektor $x^{(t)}$ an die Eingabeknoten an.
Berechne die Wahrscheinlichkeit für jede Hidden Unit, dass diese gleich 1 ist. Setze sie mit dieser Wahrscheinlichkeit gleich 1.
Berechne die Wahrscheinlichkeit für jeden Eingabeknoten, dass dieser gleich 1 ist. Setze ihn mit dieser Wahrscheinlichkeit gleich 1.
Gehe zu Schritt 2. Wiederhole dies für $k$ Schritte (dies wird auch Gibbs-Sampling genannt).
Das, was nach dem $k$-fachen Gibbs-Sampling in der Eingabeschicht
steht, wird auch "negative sample $\tilde x$" genannt.
Update der Parameter:
\begin{align}
W &\leftarrow W + \eta (h(x^{(t)}) {x^{(t)}}^T - h(\tilde x) {\tilde x}^T)\\
b_h &\leftarrow b_h + \eta (h(x^{(t)}) - h(\tilde x))\\
b_v &\leftarrow b_v + \eta (x^{(t)} - \tilde x)
\end{align}
wobei $\eta \in (0, 1)$ die Lernrate ist,
$b_h \in \mathbb{R}^{n_h}$ der Bias-Vektor der Hidden Units und
$b_v \in \mathbb{R}^{n_v}$ der Bias-Vektor der Eingabeknoten ist.
$h = \text{sigmoid}(b_h + W x)$ ist ein Vektor, welcher für die
einzelnen Hidden Units sagt, wie wahrscheinlich es ist, dass diese
gleich 1 sind.
In der Praxis funktioniert es schon mit $k=1$ für Pre-Training. Wenn
$k$ groß ist, konvergiert $\tilde x$ gegen den wahren Modellwert. Das
wäre dann eine Monte-Carlo Estimation.
Simulated annealing ist ein heuristisches Optimierungsverfahren.
Sei $D$ der Definitionsbereich einer Funktion $f: D \rightarrow \mathbb{R}$
und $U: D \rightarrow \mathcal{P}(D)$ eine Funktion, welche die
Umgebung eines Punktes angibt. Sei $T: \mathbb{N}_0 \rightarrow \mathbb{R}_{> 0}$
die Temperatur zum Zeitpunkt $t \in \mathbb{N}_0$.
Gesucht ist $\text{arg min}_{x \in D} f(x)$.
Wähle zum Zeitpunkt $t=0$ einen zufälligen Startwert $x \in D$.
Gehe nun iterativ vor und jeweils einen Zeitschritt weiter:
Nimm einen Punkt aus der Umgebung $y \in U(x)$. Wenn
$f(y) \leq f(x)$, dann überschreibe $x \leftarrow y$. Falls nicht,
dann überschreibe es mit der Wahrscheinlichkeit $\exp \left (-\frac{f(y)-f(x)}{T(t)} \right )$.
Speichere in jedem Schritt den bisher besten Wert.
Anwendungen:
Hopfield-Netze: Hopfield-Netze kann man für das TSP einsetzen und auch als Assoziativspeicher nutzen. Allerdings haben sich Hopfield-Netze nie wirklich durchgesetzt.
Ein rekurrentes neuronales Netzwerk, bei dem die Ausgabe der
Ausgabeschicht im nächsten Zeitschritt als Eingabe verwendet wird.
Backpropagation through Time (BPTT)
Ein Trainingsalgorithmus für rekurrente neuronale Netze, bei dem
das Netz über die Zeit "ausgerollt" wird. Das rekurrente Netz wird also
als nicht-rekurrentes Netz mit einer Kopie der Schichten pro
Zeitschritt behandelt.
Das Problem des verschwindenden Gradienten ist eine Herausforderung im
Kontext neuronaler Netze, welche mit Backpropagation trainiert
werden. Insbesondere bei sehr tiefen oder rekurrenten Netzen
kann es passieren, dass der Gradient bei den ersten Schichten sehr
niedrig ist, sodass das Netz sehr langsam lernt. Aufgrund numerischer
Ungenauigkeit kann dies sogar dazu führen, dass das Netz in den
ersten Schichten nicht lernen kann.
Ein LSTM ist ein Typ eines neuronalen Netzwerks. Das Besondere an
LSTM-Netzen sind "intelligente" Neuronen, welche über Gates bestimmen,
ob ein Wert gespeichert wird und wie lange.
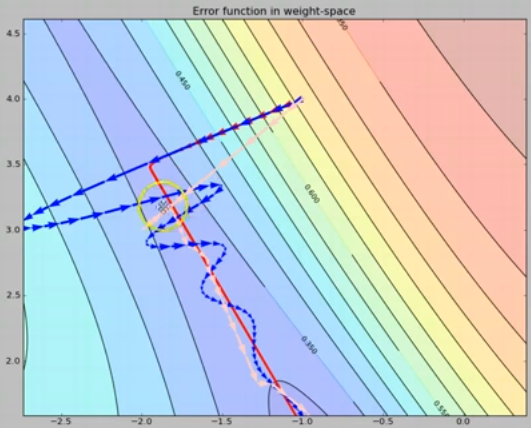
In der Update-Regel $\Delta w_{ij}^* (t+1) = \Delta w_{ij} (t+1) + \alpha \Delta w_{ij}(t)$ wird der Term $\Delta w_{ij}(t)$ als Momentum bezeichnet.
Der Skalar $\alpha \in [0, 1]$ gewichtet diesen und ist ein
Hyperparameter.
Quickprop ist ein Trainingsverfahren für neuronale Netze. Der Lernalgorithmus
nimmt an, dass die Fehlerfläche lokal durch eine Parabel approximiert
werden kann. Das Gewichtsupdate im Schritt $k$ ist demnach vom
Gradienten und dem Gewichtsupdate des vorherigen Schrittes abhängig:
$$\Delta^{(k)} \, w_{ij} = \Delta^{(k-1)} \, w_{ij} \left ( \frac{\nabla_{ij} \, E^{(k)}}{\nabla_{ij} \, E^{(k-1)} - \nabla_{ij} \, E^{(k)}} \right)$$
Weight Decay
Passe die Fehlerfunktion an: $E = MSE + \lambda \sum_{i,j} w_{ij}^2$
Weight Elimination
Passe die Fehlerfunktion an: $E = MSE + \lambda \sum_{i,j} \frac{w_{ij}^2}{1+w_{ij}^2}$
Optimal Brain Damage (OBD)
Optimal Brain Damage entfernt nach dem Training Verbindungen, die
sehr kleine $|w_{ij}|$ haben.
Besser: Entferne Verbindungen, die geringen Einfluss auf die
Fehlerfunktion haben.
Cascade Correlation ist ein konstruktiver Algorithmus zum Erzeugen
von Feed-Forward Neuronalen Netzen. Diese haben eine andere Architektur
als typische multilayer Perceptrons. Bei Netzen, welche durch
Cascade Correlation aufgebaut werden, ist jede Hidden Unit mit
den Input-Neuronen verbunden, mit den Output-Neuronen und mit allen
Hidden Units in der Schicht zuvor.
Meiosis Netzwerke bauen ein neuronales Netz auf. Sie beginnen mit einer
einzelnen hidden Unit. Diese hidden Unit wird aufgespalten, wenn die
"Unsicherheit" zu groß ist (vgl. Paper für Kriterium; vgl. summary).
Häufig wird die Architektur neuronaler Netze grafisch dargestellt. Dabei ist
mir Folgendes aufgefallen:
Im Inneren von Neuronen wird die Aktivierungsfunktion "geplottet". Das heißt
bei der Sigmoidfunktion wird etwas S-förmiges dargestellt, bei der
sign-Funktion etwas Eckiges, bei ReLU ein horizontaler Strich gefolgt von
einem Strich im 45-Grad-Winkel.
Typischerweise ist der Input links (oder alternativ unten) und der Output
rechts (oder alternativ oben)
Interpretation of errors
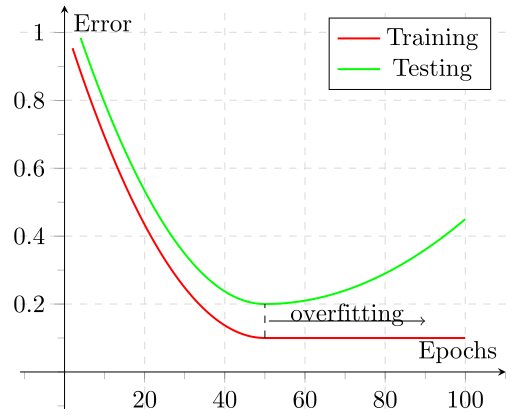
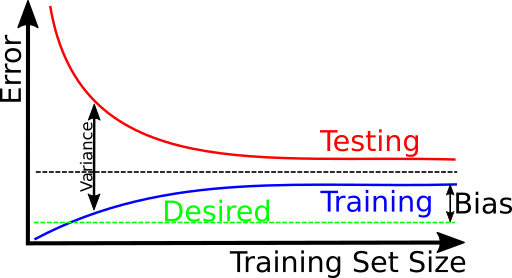
Figure 5: Training and Testing error over epochs. At some point overfitting happens.Figure 6: Training and Testing error over training data. At some point overfitting happens.
If you have a problem with high variance (overfitting), you can get more
data, use fewer features, regularize more strongly or stop training earlier.
If you have a problem with high bias (underfitting), you should get better
features or a more powerful classifier.
Please note that Figure 6 also gives you a feeling for how much new
training data will help you with your problem.
Aktivierungsfunktionen
Name
Function $\varphi(x)$
Range of values
Differentiable
$\varphi'(x)$
Layer
Comment
Signum
$\varphi(x) = \begin{cases}+1 &\text{if } x > 0\\-1 &\text{if } x < 0\end{cases}$
$\{-1, 1\}$
Yes (except 0)
$\varphi'(x) = 0$
No
Heaviside Step function
$\varphi(x) = \begin{cases}+1 &\text{if } x > 0\\0 &\text{if } x < 0\end{cases}$
Was ist der Unterschied zwischen Backpropagation und Gradient descent?
Backpropagation ist ein geschicktes Verfahren, um den Gradienten für den
Gradientenabstieg zu berechnen. Dabei wird vermieden, Berechnungen mehrfach
durchzuführen.
[Ham90] J. Hampshire and A. Waibel.
A Novel Objective Function for Improved Phoneme Recognition Using Time Delay Neural Networks. IEEE Transactions on Neural Networks, 1990.