In der Vorlesung 'Analysetechniken für große Datenbestände' werden vor allem Association Rule Mining und Clustering-Techniken besprochen. Zum Association Rule Mining ist vor allem der Apriori-Algorithmus sowie die Verbesserung mit FP-Trees zu nennen. Beim Clustering sind k-means, EM, DBSCAN, OPTICS und BIRCH von großer Bedeutung. Ein weiteres großes Kapitel sind Bayessche Netze.
Behandelter Stoff
Übersicht
| Datum | Kapitel | Inhalt |
|---|---|---|
| 20.10.2015, 08:00 | Einleitung (Folie 1-26) | Overfitting, Entscheidungsbäume, 1-Rules (→ Decision Stump), Outliers Mengenwertige Attribute, Kategorische Attribute, Zeitreihen Clustering Market Basket Analysis: Zusammenhang zwischen Waren Association rules (Apriori-Algorithmus) |
| 20.10.2015, 11:30 | Einleitung, Statistische Tests (Folie 27 - 43) | Predictive Maintenance |
| 27.10.2015, 08:00 | Statistische Tests (Folie 38 - ) | $\chi^2$-Test, $\chi^2 = \sum_{i=1}^{m_1} \sum_{j=1}^{m_2} \frac{(h_{ij}- e_{ij})^2}{e_{ij}}$ mit erwartetem Wert $e$ (Sind zwei Zufallsvariablen unabhängig) Kolmogorov-Smirnov-Test (Folgt eine Stichprobe einer vorgegebenen Verteilung? Bei stetigen Zufallsvariablen) Wilcoxon-Mann-Whitney-Test Bernoulli-Experiment (Folie 53?) Datenreduktion (Attribute entfernen, z.B. PCA; Datensätze entfernen, z.B. Clustering; Attributsgenauigkeit reduzieren) Diskretisierung: Zielfunktion ist Information Gain. Dieser soll maximiert werden. |
| 03.11.2015, 08:00 | Räumliche Indexstrukturen | Wiederholung der Statistischen Tests |
| 03.11.2015, 11:30 | Entscheidungsbäume, Evaluation (1-18) | Split-Attribute, Pruning; Loss-Funktionen |
| 17.11.2015, 08:00 | Evaluation (19-47) | Qualitätsmaße (Korrelationskoeffizient) |
| 17.11.2015, 11:30 | Evaluation, Association Rules (1-26) | 41 min Evaluation, dann Association Rules. Frequent Itemset, Apriori-Algorithmus |
| 24.11.2015, 08:00 | Kapitel 6: Association Rules (12-Ende), Kapitel 7 (1-12) | Apriori-Algorithmus, Hash-Tree, Multidimensionale Association Rules, Level-Crossing-Association Rules, FP-Trees |
| 01.12.2015, 08:00 | Kapitel 7, Kapitel 8 (Pattern Mining mit Constraints) | Korrekturen zu Kapitel "Evaluation"; Wiederholung von Apriori-Algorithmus und Hash-Filter; ab Minute 27 FP-Trees |
| 01.12.2015, 11:30 | Kapitel 8 (Pattern Mining mit Constraints), Kapitel 9 (Clustering) | Meta-Rule-Guided Mining, Anti-Monotonizität, Support-basiertes Pruning, Constrained Sequences, Clustering Criterion Function |
| 15.12.2015, 08:00 | Kapitel 9 (Clustering) | k-means; CF-Trees |
| 15.12.2015, 11:30 | Kapitel 9 (Clustering) | CF-Trees; Hierarchisches Clustern mit Minimum Spanning Tree; DIANA; Hochdimensionale Merkmalsräume |
| 08.12.2015, 08:00 | R-Übung | - |
| 19.01.2016, 08:00 | Kapitel 9 | Jaccard-Koeffizient, ... |
| 19.01.2016, 11:30 | Kapitel 9; Kapitel 10 (1 - ) | EM-Algorithmus; Generative Modelle |
| 26.01.2016, 08:00 | Übung | - |
| 26.01.2016, 11:30 | Kapitel 10 | Regression |
| 02.02.2016, 08:00 | Kapitel 10 | Logistische Regression, Cross Entropy |
Einleitung
Slides: 1-Einleitung.pdf
- Aufgabentypen
- Klassifikation
- Clustering
- Finden von Association Rules
- 1-Rule (Decision stump)
- 1-Rules ist ein Klassifikationsverfahren. Jedes Attribut wird für sich betrachtet. Es wird anhand von dem Attribut gesplittet, bei dem die Fehlerquote am geringsten ist.
- Clustering
- Suchen von Punkten, die nahe beieinander liegen.
Unterschiede:
- Attribute: Abstandsmaße
- Form
- Dichte
- Größe
- Zeitlicher Aspekt: Alte Daten weniger wichtig
- Alternate Clustering
- Association Rules
- Association Rules sind Regeln der Form:
Wenn eine Transaktion A enthält, dann auch B (formal: $A \Rightarrow B$).
Association rules werden z.B. in der Market Basket Analysis eingesetzt. Sie können aus Frequent item sets relativ einfach erzeugt werden.
Der Apriori-Algorithmus dient dem Finden von Association Rules.
Association Rules sind stark mit Collaborative filtering verwandt. - Predictive Maintenance
- Ziel: Für Motoren will man vorhersagen, wann diese einen Fehler aufweisen
und damit gewartet werden müssen.
Dabei gibt es zwei Fehlerarten, die unterschiedlich hohe Kosten
aufweisen:
- Ausfall wird vorhergesagt, tritt aber nicht ein: Unnötige Wartung
- Ausfall wird nicht vorhergesagt, tritt aber ein: Teurer Ausfall
- Change detection
- Erkennung wesentlicher Veränderungen in einer Zeitreihe.
Statistische Grundlagen
Slides: 2-statistGrundlagen.pdf
- Skalen von Merkmalen
- Siehe Mustererkennung
- Kennzahlen für Daten
-
- Median / Mean
- Min / Max
- Quantile
- Varianz / Streuung
- Outlier
- Metrische Daten
- Ein metrischer Raum ist eine Menge $M$ mit einer Funktion
$d: M \times M \rightarrow \mathbb{R}_0^+$ für die gilt:
- Symmetrie: $\forall p,q \in M: d(p, q) = d(q, p)$
- Definitheit: $\forall p,q \in M: d(p, q) = 0 \Leftrightarrow p = q$
- Dreiecksungleichung: $\forall p,q,r \in M: d(p, r) \leq d(p,q) + d(q, r)$
- Aggregatfunktion
- Eine Funktion, welche als Eingabe eine Menge von Werten erwartet und
einen Wert ausgibt (z.B. SUM, COUNT, MIN, MAX, AVG, MEAN,
häufigster Wert, Truncated Average, mid range).
Aggregatfunktionen sind entweder distributiv, algebraisch oder holistisch. - Distributive Aggregatfunktion
- Es gibt eine Funktion $G$, so dass $$F(\{X_{i,j}\}) = G(\{F(\{X_{i,j} | i=1, \dots, l\}) | j = 1, \dots, J\})$$ MIN, MAX und COUNT sind distributive Aggregatfunktionen.
- Algebraische Aggregatfunktion
- Es gibt eine Funktion $G$, die ein $M$-Tupel liefert und $H$,
so dass
$$F(\{X_{i,j}\}) = H(\{G(\{X_{i,j} | i=1, \dots, l\}) | j=1, \dots, J\})$$
AVG ist eine algebraische Aggregatfunktion. Hier berechnet $G$ die
Summe und gibt zusätzlich die Anzahl der Werte zurück. $H$ summiert
die Summen auf und teilt das Ergebnis durch die Gesamtzahl.
Weitere: Truncated Average - Holistische Aggregatfunktion
- Man kann keine Beschränkung des Speicherbedarfs für Sub-Aggregate,
d.h. Aggregate über $\{X_{i,j}| i=1, \dots, l\}$, angeben.
Der häufigste Wert und der Median sind holistische Aggregatfunktionen. - Self-Maintainable Aggregatfunktion
- Wenn man den aktuellen Wert der Aggregatfunktion kennt und man löscht
einen Wert bzw. fügt einen Wert ein, dann kann man direkt den neuen
Wert der Aggregatfunktion über den angepassten Datenbestand berechnen.
Nicht-self-maintainable ist der häufigste Wert.
MIN und MAX sind self-maintainable bzgl. Einfügen. - Mid-Range
- $$\frac{MAX+MIN}{2}$$
- Entropie
- $$E(S) = - \sum_{j} p_j \cdot \log p_j$$ $E(S)=0$ ist minimal, wenn es ein $j$ gibt mit $p_j = 1$. $E(S)=\log(n)$ ist maximal, wenn $p_i = p_j$ gilt für alle $i, j$.
- Korrelationsmaße
- Sind üblicherweise auf [-1, 1] normiert. Die Kovarianz ist ein nicht-normiertes Korrelationsmaß.
- Kovarianz
- $$\operatorname{Cov}(X,Y) := \operatorname E\bigl[(X - \operatorname E(X)) \cdot (Y - \operatorname E(Y))\bigr]$$
- Korrelationskoeffizient
- $$\varrho(X,Y) =\frac{\operatorname{Cov}(X,Y)}{\sigma(X)\sigma(Y)} \in [-1, 1]$$
- PCA (Principal Component Analysis)
- PCA ist ein Algorithmus zur Reduktion von Daten durch das Entfernen von Attributen. Er projiziert die Datenobjekte auf einen niedrigdimensionalen Unterraum, sodass ein Maximum der Varianz beibehalten wird (vgl. Neuronale Netze)
- Chi-Quadrat-Test
- Oberbegriff für mehrere Tests; hier nur der Unabhängigkeitstest.
Gegeben sind zwei Verteilungen von Zufallsvariablen $X, Y$. Die Frage ist, ob sie unabhängig sind.
Dazu zählt man die Ausprägungen $i=1, \dots, m_1$ des Merkmals $X$ und die Ausprägungen $j=1, \dots, m_2$ des Merkmals $Y$ sowie wie häufig diese in Kombination auftreten ($n_{ij}$). Man schätzt den erwarteten Wert durch $e_{ij} = \frac{1}{n} \left(\sum_{k=1}^{m_2} n_{ik} \right) \cdot \left (\sum_{k=1}^{m_1} n_{kj}\right )$. Der Chi-Quadrat-Wert ist dann: $$\chi^2 = \sum_{i=1}^{m_1} \sum_{j=1}^{m_2} \frac{(n_{ij} - e_{ij})^2}{e_{ij}}$$ Daraus wird ein $p$-Wert abgeleitet. Wenn dieser unter einem Schwellwert wie $\alpha = 0.01$ ist, dann wird die Hypothese, dass die Verteilungen unabhängig sind, zurückgewiesen. Die Nullhypothese, dass $X, Y$ unabhängig sind, wird auf dem Signifikanzniveau $\alpha$ verworfen, falls $$\chi^2 > \chi^2_{(1-\alpha; (m_1-1)(m_2-1))}$$ - Kolmogorow-Smirnow-Test (KS-Test)
- Anpassungstest für stetige Verteilungen: Folgt die Stichprobe einer vorgegebenen Verteilung $F_0$? Also: $$H_0: F_X(x) = F_0(x)$$ Es wird die empirische Verteilungsfunktion $S$ gebildet und diese mit der hypothetischen Verteilungsfunktion $F_0$ verglichen, wobei $S(x_0) = 0$ gesetzt wird: $$d_{\max} = \max(\max_{i=1, \dots, n}|S(x_i) - F_0(x_i)|, \max_{i=1, \dots, n} |S(x_{i-1}) - F_0(x_i)|)$$ $H_0$ wird verworfen, wenn $d_{\max} > d_\alpha$, wobei $d_\alpha$ bis zu $n=35$ tabelliert vorliegt. Bei größerem $n$ kann näherungsweise $$d_\alpha = \sqrt{\frac{-\frac{1}{2} \ln(\frac{\alpha}{2})}{n}}$$ verwendet werden.
- Wilcoxon-Mann-Whitney-Test ($U$-Test)
- Es seien $X,Y$ Zufallsvariablen mit Verteilungsfunktionen
$F_X(x) = F_Y(x-a)$ für ein $a \in \mathbb{R}$.
$H_0: a = 0$ vs $H_1: a \neq 0$
Vorgehen: Gemeinsame Stichprobe sortieren, Rangsumme für $X$ und $Y$ bilden, Betrag der Differenz mit Tabelleneintrag vergleichen. - Datenreduktion
-
- Numerosity Reduction: Reduziere die Anzahl der betrachteten
Datenobjekte
- Parametrische Verfahren: Nimm eine bekannte Wahrscheinlichkeitsverteilung der Datenobjekte an und schätze deren Parameter. Arbeite dann nur mit der Verteilung
- Nichtparametrische Verfahren: Sampling, Clustering, Histogramme
- Dimensionality Reduction: Reduziere die Anzahl der Attribute.
- Forward Feature Construction: Starte nur mit einem Feature und gib dem Classifier so lange neue Features, bis die gewünschte Genauigkeit erreicht wurde.
- Feature Elimination: Starte mit allen Features und entferne so lange Features, wie die gewünschte Genauigkeit erhalten bleibt.
- PCA
- Diskretisierung: Reduziere die Werte pro Attribut.
- Numerosity Reduction: Reduziere die Anzahl der betrachteten
Datenobjekte
- Visualisierung von Daten
-
- Boxplots: Whiskers
- Histogramme: Nicht geeignet für viele Dimensionen.
- Dendrogramme
- Grundbegriffe der Wahrscheinlichkeitstheorie
-
- Wahrscheinlichkeitsraum
- Ereignis
- Ergebnis
- Ergebnismenge $\Omega$
- Wahrscheinlichkeitsmaß
- Kovarianzmatrix
- Bernoulli-Experiment
Räumliche Indexstrukturen
Slides: 3-Informatik-Grundlagen.pdf
- B+-Tree (see YouTube)
- A balanced search tree.
- Index
- Beschleunigung der Suche von linearer Suchzeit auf logarithmische durch B+-Bäume.
- Anfragetypen
-
- Punkt-Anfragen: Ist ein Punkt im Datensatz?
- Bereichs-Anfragen: Ist mindestens ein Datenobjekt im gegebenen Bereich?
- Nearest-Neighbor-Anfragen (NN-Anfragen): Was ist das nächste Datenobjekt zu einem gegebenen Punkt?
- kD-Baum
- Siehe Computergrafik.
- kDB-Baum
- Ein balancierter kD-Baum. Die Balancierung wird durch eine Kombination aus heterogenem k-d-Baum und B*-Baum erreicht. Der Baum ist also nicht auf logischer, sondern nur auf physischer Ebene balanciert.
- R-Baum
- Ein R-Baum ist ein balancierter Baum, welcher die Datenobjekte in
minimale AABBs
einschließt. Jeder Knoten hat eine solche AABB und jedes der Kinder -
egal ob es wieder eine AABB oder Datenpunkte sind - ist darin.
Diese AABBs können sich überschneiden.
Siehe auch: What is the difference between a R-tree and a BVH? - Nearest Neighbor in R-Tree
- Siehe Pseudo-Code.
Entscheidungsbäume
Slides: 4-Entscheidungsbaeume.pdf
Dieses Kapitel beschäftigt sich mit der Klassifikation mit Entscheidungsbäumen.
- Qualitätskriterien für Entscheidungsbäume
-
- Ergebnisqualität
- Kompaktheit: Je kompakter der Baum, desto besser kann die Entscheidung vom Benutzer nachempfunden werden.
- Wahl der Split-Attribute
- Entropie eines Splits minimieren: $$E(S_1, S_2) = \frac{n_1}{n} E(S_1) + \frac{n_2}{n} E(S_2)$$
- Overfitting
- Entscheidungsbaum ist zu sehr an Trainingsdatenbestand angepasst
- Prepruning (Forward pruning)
- Schon beim Erstellen des Entscheidungsbaumes wird ab einer gewissen Tiefe abgebrochen
- Postpruning (Backward pruning)
- Der Entscheidungsbaum wird komplett aufgebaut, aber danach wird gepruned.
Evaluation
Slides: 5-Evaluation.pdf
- Resubstitution Error
- Trainingsfehler
- $k$-Fold Cross-Validation (Kreuzvalidierung)
- Unterteile den Datensatz in $k$ Teile. Dabei sollten die Klassen in etwa gleich häufig in allen Teilen vorkommen. Mache nun $k$ Durchläufe, wobei im $i$-ten Durchlauf der $i$-te Teil zum Testen und alle anderen zum Trainieren verwendet werden. Berechne die $k$ Testfehler. Mittle diese am Ende. Das ist ein besserer Schätzwert für den realen Fehler als eine einmalige Unterteilung in Trainings- und Testmenge.
- Stratification
- Sicherstellen, dass bestimmte Eigenschaften (z.B. Klassenzugehörigkeit) in Partitionen etwa gleich verteilt sind.
- Loss function
- Eine Funktion, die angibt, wie viel man durch eine unkorrekte Vorhersage verliert.
- Informational Loss function
- $$- \log_2 p_i$$ - Wahrscheinlichkeiten der nicht-eintretenden Klassen spielen keine Rolle
- Quadratic Loss function
- $$\sum_{j} (p_j - a_j)^2$$ mit tatsächlichem Label $a_j \in \{0,1\}$ und geschätzter Wahrscheinlichkeit $p_j$ für die Klasse $j$.
- Bias
- Das Verfahren an sich funktioniert nicht gut. Selbst beliebig viele Trainingsdaten beheben dieses Problem nicht. Der Fehler ist inhärent im Verfahren verankert.
- Varianz
- Fehler, welcher durch das Fehlen von Trainingsdaten verursacht wird.
- Gesamt-Erfolgsquote
- $$\frac{TP+TN}{TP+TN+FP+FN}$$
- Konfusionsmatrix (Confusion matrix)
- Eine Tabelle, in der die Zeilen für die tatsächlichen Klassen stehen und die Spalten für die vorhergesagten Klassen. Die Diagonalelemente zählen also die richtig vorhergesagten Datenobjekte; alle anderen Zellen zählen falsche Vorhersagen.
- Kappa-Koeffizient (Cohens Kappa)
- Vergleich mit Klassifikator, der nur den Anteil der Klassenzugehörigkeit schätzt: $$\kappa =\frac{p_0-p_c}{1-p_c}$$ wobei $p_0$ die gemessene Übereinstimmung ist und $p_c$ die erwartete Übereinstimmung bei Unabhängigkeit. Wenn also $h_{ij}$ die Anzahl der Datenobjekte ist, für die der erste Klassifizierer die Klasse $i$ und der zweite Klassifizierer die Klasse $j$ vorhergesagt hat sowie $N$ die Gesamtzahl der Datenobjekte und $z$ die Gesamtzahl der Klassen, dann gilt: $$p_0 = \frac{\sum_{i=1}^z h_{ii}}{N}$$ Die erwartete Übereinstimmung $p_c$ wird über die Randhäufigkeiten geschätzt: $$p_c = \frac{1}{N^2} \sum_{i=1}^z h_{.i} \cdot h_{i.}$$ Der Wertebereich ist also: $\kappa \in (-\infty; 1]$, wobei der minimale Wert von $\kappa$ nicht beliebig klein werden kann.
- Lift-Faktor
- Faktor, um den sich die Rücklaufquote erhöht: $$\mathrm{lift}(X\Rightarrow Y) = \frac{ \mathrm{support}(X \cup Y)}{ \mathrm{support}(X) \cdot \mathrm{support}(Y) }$$ Der Lift ist ein Indiz für die Unabhängigkeit von $X$ und $Y$. Ist der Lift nahe bei 1, dann spricht das für die Unabhängigkeit. Ein Lift-Faktor kleiner als 1 bedeutet, dass die Itemsets zusammen seltener vorkommen als bei Unabhängigkeit zu erwarten wäre. Ein Lift-Faktor von größer als 1 bedeutet, dass die Itemsets zusammen häufiger vorkommen als bei Unabhängigkeit zu erwarten wäre.
- ROC (Receiver Operating Characteristic)
- x-Achse: $\frac{FP}{FP+TN} \cdot 100$ (FP-Rate),
y-Achse: $\frac{TP}{TP+FN} \cdot 100$ (TP-Rate)
Siehe auch: Namensherkunft - Recall (True Positive Rate, TPR, Sensitivität)
- $$TPR = \frac{TP}{TP + FN} = 1 - FNR \in [0, 1]$$ Der Recall gibt den Anteil der erkannten Positiven aus allen Positiven an. Sensitivität ist ein in der Medizin üblicher Begriff.
- Precision (Genauigkeit)
- $$Precision = \frac{TP}{TP + FP} \in [0, 1]$$ Die Precision gibt den Anteil der real Positiven aus den als positiv Erkannten an.
- F-Measure (F1 score)
- $$\frac{2 \cdot \text{precision} \cdot \text{recall}}{\text{recall} + \text{precision}}$$
- Correlation Coefficient
- Der Correlation Coefficient ist kein Fehlermaß. Der $CC(p, a)$ ist groß, wenn sich $p$ und $a$ ähnlich sind. $$CC(p, a) = \frac{COV(p, a)}{\sigma(p) \cdot \sigma(a)}$$ Mit $\sigma(x) = \sqrt{\frac{1}{n-1} \cdot \sum_{i} (x_i - \bar{x})^2}$
- Code
- Abbildung, die jedem Element des Alphabets eine Folge aus 0en und
1en zuweist.
Beispiele:
- Morse-Code
- Unicode
- ASCII-Code
- Minimum Description Length (MDL)
- Minimale Länge zum Beschreiben des Modells.
Weiteres:
- Qualitätsmaße für numerische Vorhersagen
Fragen:
- Folie 23: Wo kommt die 140 her?
→ Summe der Diagonalelemente auf Folie 21. - Folie 27: Lift Faktor ist 2 wenn man nur die 400 anschreibt, oder?
Association Rules
Slides: 6-Association-Rules-1.pdf und 7-Association-Rules-2.pdf
Es zieht sich die Warenkorbanalyse als Beispiel durch. Allerdings sind folgende Anwendungen von Association Rules denkbar:
- Netflix: Man kennt User und welche Filme diese mögen (5 Sterne). Welche weiteren, unbewerteten Filme könnten diesen gefallen?
- Amazon: Im Warenkorb sind Produkte XY. Was wird der User wohl noch kaufen?
- Online-Konfiguratoren: Welche Konfigurationen sollte man "bündeln", z.B. bei Autos in eine "Sport-Variante"?
- Last.fm: Music Recommendations
- Medicine: Implementation of Apriori Algorithm in Health Care Sector: A Survey
- Frequent Itemset
- Ein Frequent Itemset ist eine Menge von Items, die häufig zusammen gekauft werden.
- Transaktion (Itemset)
- Menge von Items, die zusammen gekauft wurden.
- Association rules
- Drücken aus, wie Phänomene zueinander in Beziehung stehen. Beispiel: Wer Bier kauft, der kauft auch Chips.
- Support
- Die Anzahl der Transaktionen, die das Itemset $I$ enthalten, wird
Support von $I$ genannt.
Es gilt: $$\text{support}(A \Rightarrow B) = \text{support}(A \cup B)$$ - Closed Itemset
- Ein Itemset $I$ heißt closed, wenn es keine echte Obermenge $I' \supsetneq I$ gibt, die den gleichen Support $\text{support}(I') = \text{support}(I)$ hat.
- Confidence
- Confidence von $A \Rightarrow B$ ist der Anteil der Transaktionen, die $A$ und $B$ enthalten, von den Transaktionen, die $A$ enthalten: $$\text{conf}(A \Rightarrow B) = \frac{\text{support}(A \cup B)}{\text{support}(A)} \in [0, 1]$$
- Apriori-Algorithmus
- Der Apriori-Algorithmus ist ein Generate-and-Test-Algorithmus zum
Finden von Frequent Itemsets.
- Erzeuge alle einelementigen Frequent Itemsets
- for k in range(2, n): Erzeuge die $k$-elementigen frequent Itemsets (join, prune, support counting)
- Aus den Frequent Itemsets die Association Rules erzeugen
- Stichproben verwenden (Sampling)
- Aggressiver durch Datenbestand gehen (z.B. von k=3 zu k=6 springen)
- Hashfilter
- Hash-Filter (Hash-Tabelle)
- Unterstützt das Support-Counting für viele Kandidaten. Die Hash-Tabelle wird einmalig für alle Kandidaten der Länge $k$ aufgebaut und stellt eine notwendige, aber keine hinreichende Bedingung für Frequent Itemsets dar.
- Hash Tree
- Wenn man viele Kandidaten für $k$-elementige Frequent Itemsets hat,
dann kann das support counting lange dauern. Deshalb baut man sich
vor dem Support Counting für alle Kandidaten einen Hash-Tree mit
$k$ Ebenen auf. Man sortiert die Items der Kandidaten auf, indem
man einen Pfad für jeden Kandidaten im Baum hinzufügt. Jeder
Knoten im Hash-Tree entspricht also einem Item. Ein Item $i$ in Ebene
$j$ steht dafür, dass der Kandidat an Stelle $j$ das Item $i$ hat.
Allerdings kann man auch früher aufhören, wenn es keine Kollisionen
gibt.
Der Hash-Tree repräsentiert also die Kandidaten, nicht die Transaktionen.
- FP-Trees
- FP-Trees (FP für "frequent pattern") sind eine Datenstruktur zum
schnellen Finden von Frequent Itemsets. Jeder Knoten im Baum
repräsentiert ein Item. Jeder Knoten speichert zusätzlich die
Häufigkeit des Präfixes, welcher durch den Pfad von der Wurzel zu dem
Knoten dargestellt wird. Zusätzlich speichert jeder Knoten des Items
$i$ einen Zeiger auf einen anderen Knoten mit einem Item $i$. Jede
Transaktion entspricht einem Pfad im FP-Tree.
Zusätzlich zum FP-Tree gibt es eine Header-Tabelle. Die Zeilen dieser Tabelle sind einzelne Items $i$, denen jeweils ein Zeiger auf einen Knoten im FP-Tree zugeordnet ist, der auch das Item $i$ repräsentiert.
Für jedes Item gibt es also eine verkettete Liste, die das Vorkommen im Baum angibt.
Zum Finden von Frequent Items geht man also wie folgt vor:- Für jedes Item: Zähle, in wie vielen Transaktionen das Item vorkommt.
- Sortiere Items in Transaktion absteigend nach Häufigkeit. Bei gleicher Häufigkeit wird z.B. alphabetisch sortiert. Damit ergibt sich eine eindeutige Reihenfolge.
- Sortiere Transaktionen nach den Items innerhalb der Transaktionen.
- Aufbau des FP-Trees
- Aufbau des Baums
- Aufbau der Header-Tabelle: Absteigend eindeutig nach Häufigkeit sortiert
- Starte mit dem niedrigsten Element in der Header-Tabelle. Überprüfe den Präfix auf den erwarteten Support. Gehe dazu alle Elemente dieses Items durch (alle Präfix-Pfade im Baum) und wende eine Art Apriori-Algorithmus an, um in diesen Präfix-Pfaden mit dem Item $i$ die Frequent-Itemsets zu finden.
- Sampling
- Berechnung auf einer Stichprobe durchführen
- Negative Border
- Die negative border ist abhängig vom minimalen geforderten Support. Wenn dieser Schwellenwert größer wird, wandert die negative border nach oben; es gibt also weniger frequent Itemsets.
- Projected Database
- Zerlegung des Datenbestands in Partitionen (z.B. Transaktionen mit Item A und Transaktionen ohne Item A).
Siehe auch:
Constraints
Slides: 8-ConstrainedAssociationRules.pdf
- Constraint-Typen
-
- Data Constraints: Einschränken auf konkrete Werte, z.B. Transaktionen, bei denen der Ort Karlsruhe ist.
- Rule Constraints: z.B. nur Itemsets der Größe 3
- 1-var Constraint
- Nur eine Seite (links oder rechts) der Association Rule wird eingeschränkt.
- 2-var Constraint
- Beide Seiten (links und rechts) der Association Rule werden eingeschränkt.
- Anti-Monotonizität
- Ein 1-var Constraint heißt anti-monoton, wenn für alle Mengen $S, S'$
gilt:
$$(S \supseteq S' \land (S \text{ erfüllt } C )) \Rightarrow S' \text{ erfüllt } C$$
Wenn also ein Constraint $C$ für eine Menge $S$ erfüllt ist, dann
auch für jede Teilmenge $S'$.
Beispiele:
- $\min(S) \geq v, \;\;\; v \in \mathbb{R}$ ist anti-monoton
- $\max(S) \geq v, \;\;\; v \in \mathbb{R}$ ist nicht anti-monoton
- $\text{size}(S) \leq v, \;\;\; v \in \mathbb{N}$ ist anti-monoton
- $\text{size}(S) \geq v, \;\;\; v \in \mathbb{N}$ ist nicht anti-monoton
- Succinctness
- Ein Constraint heißt succinct, wenn alle Itemsets, die es erfüllen,
schnell erzeugt werden können.
Beispiel: Man hat das Constraint, dass der Typ "Non-Food" sein soll. Aber es gibt nur 3 Produkte, die diesen Typ haben. Kandidaten, die das Constraint nicht erfüllen, werden gar nicht erst erzeugt.
- Meta-Rule Guided mining
- Constraint durch schwächeres anti-monotones Constraint ersetzen.
Clustering
Slides: 9-Clustering-1.pdf und 9-Clustering-2.pdf
- Silhouette-Koeffizient
- Sei $C = (C_1, \dots, C_k)$ ein Clustering.
- Durchschnittlicher Abstand zwischen Objekt o und anderen Objekten in seinem Cluster: $$a(o) = \frac{1}{|C(o)|} \sum_{p \in C(o)} dist(o, p)$$
- Durchschnittlicher Abstand zum zweitnächsten Cluster: $$b(o) = \min_{C_i \in \text{Cluster} \setminus C(o)} \frac{1}{|C_i|} \sum_{p \in C_i} \text{dist}(o, p)$$
- Silhouette eines Objekts: $$s(o) = \begin{cases}0 &\text{if } a(o) = 0, \text{i.e. } |C_i|=1\\ \frac{b(o)-a(o)}{\max(a(o), b(o))} &\text{otherwise}\end{cases}$$ Es gilt: $$s(o) \in [-1, 1]$$
- $\text{silh}(C) = \frac{1}{|C|} \sum_{C_i \in C} \frac{1}{|C_i|} \sum_{o \in C_i} s(o)$. Es gilt: $$\text{silh}(C) \in [-1; 1]$$ Es ist ein möglichst großer Wert gewünscht. Alles kleiner als 0 ist schlecht.
- Distanzfunktionen für Cluster
-
Seien $X, Y$ Cluster.
- Durchschnittlicher Objektabstand: $\text{dist}_{avg}(X, Y) = \frac{1}{|X| \cdot |Y|} \cdot \sum_{x \in X, y\in Y} \text{dist}(x, y)$
- Single Link: $\text{dist}_{sl}(X, Y) = \min_{x \in X, y \in Y} \text{dist}(x, y)$
- Complete Link: $\text{dist}_{cl}(X, Y) = \max_{x \in X, y \in Y} \text{dist}(x, y)$
- $k$-means Clustering
- Siehe ML 1.
- CLARANS
- CLARANS (Clustering Large ApplicatioNs based on RANdomized Search) ist
ein Clustering-Algorithmus, der mit $k$-Means
verwandt ist. Auch er erwartet einen Parameter $k \in \mathbb{N}$,
der die erwartete Anzahl an Clustern angibt. Dann geht CLARANS davon
aus, dass jeder Medoid durch einen Datenpunkt im Datensatz
repräsentiert werden kann. Für eine zufällige Wahl von $k$ Punkten
$M = \{p_1, \dots, p_k\}$ wird ein Score berechnet. Dann überprüft
man für zufällig gewählte Paare $p_i \in M$ und $p_j \notin M$, was der
Tausch von $p_i$ durch $p_j$ am Score ändern würde. Verbessert ein
Tausch den Score, führt man ihn durch und macht mit der neuen
Medoid-Menge weiter. Bringt eine vorgegebene Anzahl zufälliger Tausche
keine Verbesserung, hat man ein lokales Optimum gefunden.
Siehe auch: CLARANS: a method for clustering objects for spatial data mining - CF-Tree (Clustering Feature Tree)
- Ein CF-Tree ist ein höhenbalancierter Baum. Jeder Knoten des Baums
entspricht einem Cluster.
Clustering-Feature (N, LS, SS) für Cluster $C_i$ mit- $N = |C_i|$: Anzahl der Punkte im Cluster
- $LS = \sum_{i \in C_i} X_i$
- $SS = \sum_{i \in C_i} X_i^2$
- BIRCH (Balanced Iterative Reducing and Clustering using Hierarchies)
- BIRCH ist ein Clustering-Algorithmus, welcher CF-Trees benutzt und
mit wenig Speicherplatz auskommt. Der CF-Tree wird im ersten Schritt
aufgebaut.
Parameter von BIRCH:- $k \in \mathbb{N}^+$: Anzahl der Cluster
- $B \in \mathbb{N}^+$: (Fan-out), maximale Anzahl an Kindknoten
- $B' \in \mathbb{N}^+$: maximale Blatt-Kapazität (Anzahl Elementarcluster)
- $T \in \mathbb{R}^+$ (Schwellwert): Maximaler Radius (oder Durchmesser), bevor ein Elementar-Cluster gesplittet wird
- Hierarchisches Clustering
- Beim hierarchischen Clustern werden Datenpunkte baumartig zu Clustern
zusammengefasst. Das Ganze sieht einem Abstammungsbaum der Arten in der
Biologie sehr ähnlich.
Es gibt zwei Vorgehensweisen: Dendrogramme sind eine typische Visualisierung für das Ergebnis einer hierarchischen Clusteranalyse. - Probabilistisches Clustering
- Datenobjekte werden nicht hart zu einem Cluster zugeordnet, sondern weich (also mit einer gewissen Wahrscheinlichkeit) jedem Cluster zugeordnet.
- Zentrum eines Clusters
- $$Z_{i} = \frac{1}{|C_i|} \sum_{j \in C_i} X_j$$
- Radius eines Clusters
- Der Radius eines Centroids ist der durchschnittliche Abstand zum Centroiden: $$R(C_i) = \sqrt{\frac{1}{|C_i|} \sum_{j \in C_i} {(X_j - Z_i)}^2}$$
- Durchmesser eines Clusters
- Der Durchmesser eines Centroiden ist die durchschnittliche paarweise Distanz: $$D(C_i) = \sqrt{\frac{1}{|C_i| \cdot (|C_i|-1)} \sum_{j \in C_i} \sum_{k \in C_i} {(X_j - X_k)}^2}$$
- Interclusterdistanz
- Durchschnittliche Inter-Clusterdistanz von Cluster 1 und Cluster 2: $$D(C_1, C_2) = \sqrt{\frac{\sum_{i \in C_1} \sum_{j \in C_2} {(X_i - X_j)}^2}{|C_1| \cdot |C_2|}}$$
- Agglomeratives Clustering
-
- Jedes Objekt ist ein Cluster. Füge die Cluster in die Menge $M$ ein.
- Berechne alle paarweisen Abstände zwischen Clustern in $M$. Das ist in $\mathcal{O}(|M|^2)$.
- Merge das Paar $A, B$ mit kleinstem Abstand zu $C = A \cup B$. Entferne $A, B$ aus $M$ und füge $C$ ein.
- Abbruch, wenn $|M| = 1$
- Gehe zu Schritt 2.
Siehe auch: AGNES - Divisives Clustering (DIANA, DIvisive ANAlysis)
- Divisives Clustering ist ein hierarchisches Clusteringverfahren. Es
startet mit einem großen Cluster und unterteilt diesen rekursiv immer
weiter in je zwei kleinere Cluster.
Das Unterteilen funktioniert wie folgt: Wähle in einem Cluster $C$ das Datenobjekt $o$, welches den höchsten durchschnittlichen Abstand von allen anderen Datenobjekten $o' \in C \setminus \{o\}$ hat. Dieses ist nun das erste Objekt einer neu erstellten sogenannten Splittergruppe $S = \{o\}$ (engl. splinter group). Nun gibt es noch das Maß $$D(o) = \sum_{o' \in C \setminus S} \frac{d(o, o')}{|C \setminus S|} - \sum_{o' \in S} \frac{d(o, o')}{|S|}$$ Solange $D(o) > 0$ für ein $o \in C \setminus S$ wird $o^* = \text{arg max}_{o \in C \setminus S} D(o)$ aus dem Cluster in die Splittergruppe gesteckt.
Siehe auch: - Projected Clustering
- Input sind die Anzahl $k$ der Cluster, die gefunden werden sollen und die durchschnittliche Anzahl der Dimensionen pro Cluster $l$. Output ist eine Partitionierung der Daten in $k+1$ Mengen
- Manhattan Segmental Distance
- $d(x_1, x_2) = \frac{1}{n} \cdot \sum_{i=1}^n |x_1^{(i)} - x_2^{(i)}|$ wobei $n$ die Anzahl der Dimensionen von $x_1, x_2$ ist.
- Link-based Clustering
-
- Connect all data objects which are closer than $d$
- Remove all data objects which have less than $c$ edges
- Clusters are now connected data objects. The removed elements are noise.
- Jaccard-Koeffizient
- $$J(A, B) = \frac{|A \cap B|}{|A \cup B|} \in [0; 1]$$
- DBSCAN
- DBSCAN ist ein Algorithmus zum Finden von Clustern.
Er unterscheidet 3 Arten von Datenpunkten:
- Dichte Objekte: Epsilon-Umgebung hat viele Datenobjekte.
- Dichte-erreichbare Objekte: In Epsilon-Umgebung eines dichten Objekts.
- Ausreißer: Weder dicht noch dichte-erreichbar.
- Noise
- Noise sind Punkte, die zu keinem Cluster gehören.
- Outlier
- Noise, welcher weit von jedem Objekt entfernt ist.
- Core-Distanz
- $C(o) = \min\{\varepsilon \in \mathbb{R} | o \text{ ist mit DBSCAN und } \varepsilon \text{ dicht}\}$.
Die Core-Distanz eines Objekts $o$ ist also die kleinste Distanz, sodass $o$ noch ein dichtes Objekt ist. - Reachability-Distanz
- Seien $p, o$ Datenpunkte. $$\text{reach\_d}(p, o) = \begin{cases}\max(d(p, o), \text{coreDist}(p, o)) &\text{if } d(p, o) < \varepsilon\\ \text{undefined} &\text{otherwise}\end{cases}$$
- OPTICS
- OPTICS ist ein Algorithmus, der mit den Parametern min_points und
$\varepsilon$ (maximaler Radius für Cluster-Distanz) automatisch
Cluster findet. Er startet dabei bei einem beliebigen Punkt. Dieser
Punkt definiert ein Cluster, wenn mindestens min_points von ihm aus
maximal $\varepsilon$ entfernt sind. Dann wird der nächstgelegene Punkt zu
dem Cluster hinzugefügt. Dies wird so lange gemacht, wie die Punkte
maximal $\varepsilon$ von einem Punkt im Cluster entfernt sind.
Dann wird ein bisher nicht betrachteter Punkt genommen und man
macht für diesen Outlier / neuen Cluster so weiter wie zuvor.
- ControlList (Priority Queue) enthält nur Objekte, die noch nicht in der Output-Liste sind.
- Kriterium: Minimale Reachability-Distanz zu Objekten in der Output-Liste.
- Rekursiv expandieren wie bei DBSCAN.
- Reachability-Plot (Erreichbarkeitsdiagramm)
- Der Reachability-Plot veranschaulicht die Cluster und zeigt, welche
Wahl von $\varepsilon$ zu verschiedenen Clustern in DBSCAN führen würde.
Er veranschaulicht das Ergebnis von OPTICS.
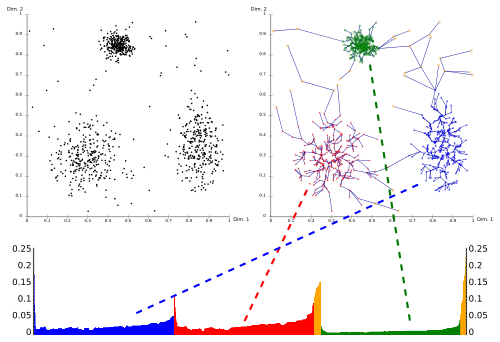
OPTICS: Der Reachability-Plot ist ganz unten. (Quelle: Wikimedia Commons) - EM-Algorithmus (Expectation Maximization)
- Siehe ML 2.
- Overall Likelihood
- Die Overall Likelihood ist ein Gütemaß für Clusterings. $$\prod_{i} \left ( p_A P(x_i | A) + p_B P(x_i | B) \right )$$

Clustering-Algorithmen
Im Folgenden sei \(k \in \mathbb{N}\) die Anzahl der Cluster, \(d \in \mathbb{N}\) die Dimension der \(n \in \mathbb{N}\) Datenpunkte.
| Algorithm | Parameters | Category | Complexity | Comment |
|---|---|---|---|---|
| $k$-means | $k$ | next neighbor based | $\mathcal{O}(dkni)$ | $i$ is the number of iterations |
| $k$-medoids | $k$ | next neighbor based | $\mathcal{O}(dk n^2 i)$ | $i$ is the number of iterations |
| EM | $k$, distribution-type | probabilistic | $\mathcal{O}(dkni)$ | $i$ is the number of iterations |
| DBSCAN | $\varepsilon$, min-points | density-based | $\mathcal{O}(n \log n)$ | requires existing index structure which executes neighborhood-query in log n |
| OPTICS | $\varepsilon$, min_points | density-based | $\mathcal{O}(n \log n)$ | $\varepsilon$ heavily influences the runtime |
| Agglomeratives hier. Clustering | number of clusters, linkage type, distance | hierarchical | $\mathcal{O}(n^2)$ | Related to Kruskal's algorithm for constructing a minimal spanning tree; looks at local patterns |
| DIANA | hierarchical | $\mathcal{O}(2^n)$ (?) | Looks at global patterns | |
| BIRCH | $k$, branching factor $B$, leaf capacity $B'$, threshold $T$ | Makes use of CF-Trees | ||
| CLARANS | like $k$-means, but jumps on graph | |||
| Projected Clustering | $k$, average number of dimensions per cluster $I$ | for high-dimensional data, extension of $k$-means | ||
| Link-based Clustering | Threshold distance $d$ for a link, minimal number of clusters $c$ |
Siehe auch: Sklearn über Clustering
Statistische Modellierung
Slides: 10-StatistModellierung.pdf
- Naive Bayes
- $$P(H | E) = \frac{P(E_1 | H) \cdot \dots \cdot P(E_n | H) \cdot P(H)}{P(E)}$$
- Laplace-Smoothing
- Um Wahrscheinlichkeiten von 0 zu vermeiden, werden die Zähler mit $k$ initialisiert. Beachte, dass man dann auch die Gesamtzahl um $k$ erhöhen muss.
- Bayessche Netze
- Siehe ML 1.
- Duplikateliminierung
- Spezialfall von Klassifikation
- Versteckte Variablen
- Abstraktion, damit der Raum der zu betrachtenden Variablen bei Bayesschen Netzen kleiner wird.
Siehe auch:
Support Vector Machines
Slides: 11-SupportVectorMachines.pdf
- Lineare Regression
- Model $y = M x$, wobei $x \in \mathbb{R}^n$ die Features sind, $y \in \mathbb{R}^m$ die Vorhersage und $M \in \mathbb{R}^{m \times n}$ die Modellparameter.
- Cross Entropy Fehlermaß
- $$E_{CE}(w) = -\sum_{i=1}^n [(1-y_i) \cdot \log (1-p_i) + y_i \cdot \log p_i]$$
- SVM (Support Vector Machine)
- See SVM article.
Ensembles
Slides: 12-Ensembles.pdf (vgl. ML 1)
- Ensembles
- Mehrere Instanzen auf Trainingsdaten trainieren.
Vorteile:
- Overfitting wird minimiert → Besseres Gesamtsystem
- Parallelisierbarkeit
- Wahrscheinlichkeiten können genauer geschätzt werden
- Bagging
- Ensemble-Learning-Technik, bei der Stichproben des Trainingsdatenbestandes für die Classifier verwendet werden.
- Relabeling
- Überschreiben der originalen Labels, z.B. wenn man eine Attributkombination mehrfach hat, aber mit unterschiedlichen Labels, dann kann dieser Kombination mit einer gewissen Wahrscheinlichkeit das jeweilige Label zugewiesen werden.
- MetaCost
- MetaCost ist ein Verfahren zum Relabeling, welches Bagging anwendet.
MetaCost: a general method for making classifiers cost-sensitive (summary) - Boosting
- Boosting ist eine Ensemble-Learning-Technik, die mehrere Modelle vom gleichen Typ durch Voting / Durchschnittsberechnung kombiniert. Dabei nimmt Boosting Rücksicht auf zuvor falsch klassifizierte Beispiele und gewichtet diese stärker. Gewichtungsänderung für korrekte Objekte bei Fehlerrate e: $\frac{e}{1-e}$
Prüfungsfragen
Was ist Overfitting?
Wie berechnet man die Kovarianz zweier Zufallsvariablen $X, Y$?
Warum muss man für NN-Anfragen mit kD-Bäumen nur ein paar Rechtecke anschauen?
Warum kann man für räumliche Anfragen nicht ohne weiteres auswerten, wenn man für jede Dimension separat einen B-Baum angelegt hat?
Wie ist ein R-Baum aufgebaut?
Wie funktioniert die Suche nach dem nächsten Nachbarn mit dem R-Baum?
Was ändert sich, wenn die Objekte eine räumliche Ausdehnung haben?
Stören uns Überlappungen von Knoten des R-Baums? Wenn ja, warum?
Wie unterscheiden sich R-Baum, kD-Baum und kDB-Baum?
Wie funktioniert das Einfügen in den R-Baum, inklusive Split?
Was für Anfragen unterstützen die diversen räumlichen Indexstrukturen?
3-Informatik-Grundlagen.pdf, Folie 19
Warum werden bei der NN-Suche nur genau die Knoten inspiziert, deren Zonen die NN-Sphere überlappen?
Welche Classifier kennen Sie?
Was ist der Vorteil von Postpruning verglichen mit Prepruning?
Wie baut man einen Entscheidungsbaum auf?
Wie kann man Overfitting beim Aufbau eines Entscheidungsbaums berücksichtigen?
Wie kann man beim Aufbau des Entscheidungsbaums berücksichtigen, dass unterschiedliche Fehlerarten unterschiedlich schlimm sind?
Was ist Wertebereich der FP-Rate?
Wie berechnet man den Korrelationskoeffizienten?
Was ist die "10-fold cross validation"?
Wie haben wir die Erfolgsquote definiert?
Was ist ein Lift Chart?
Wie unterscheidet sich ein Lift Chart von der ROC Kurve?
Was für Fehlerarten gibt es bei Vorhersagen von Klassenzugehörigkeiten?
Was für Kennzahlen kennen Sie, die diese Fehlerarten sämtlich berücksichtigen?
Was ist Unterschied zwischen Kovarianz und dem Korrelationskoeffizienten?
Warum kommt bei der informational loss Funktion die Logarithmusfunktion zur Anwendung?
Association Rules
Was sind Association Rules?
Wie findet man Association Rules?
Wie überprüft man rasch für viele Transaktionen, welche Kandidaten sie enthalten?
Wie muss der Datenbestand beschaffen sein, damit eine Association Rule $A \Rightarrow B$ hohen Support und hohe Confidence hat?
Wie muss der Datenbestand beschaffen sein, damit eine Association Rule $A \Rightarrow B$ hohen Support und geringe Confidence hat?
Wie muss der Datenbestand beschaffen sein, damit eine Association Rule $A \Rightarrow B$ geringen Support und hohe Confidence hat?
Wie muss der Datenbestand beschaffen sein, damit eine Association Rule $A \Rightarrow B$ geringen Support und geringe Confidence hat?
Im Apriori-Algorithmus hat man bei k=2 keinen Prune-Schritt. Warum?
Wie groß sollte man die Hash-Tabelle machen?
Was sind multidimensionale Association Rules?
Wie findet man multidimensionale Association Rules?
In welchen Situationen ist Apriori teuer, und warum?
Was kann man gegen die Schwächen von Apriori tun?
Was sind FP-Trees, und wie lassen sie sich für die Suche nach Frequent Itemsets verwenden?
Was kann man tun, wenn FP-Trees für den Hauptspeicher zu groß sind?
Was ist Constraint-basiertes Mining?
Was sind die Vorteile von Constraint-basiertem Association-rule Mining?
Was für Arten von Constraints kennen Sie? Beispiele hierfür.
Was ist Anti-Monotonizität, Succinctness? Für ein bestimmtes Constraint sagen/begründen, ob anti-monoton/succinct.
Wie lässt sich Apriori für das Mining von Teilfolgen verallgemeinern?
Was versteht man unter dem Antagonismus von Support-basiertem und Constraint-basiertem Pruning?
Alternativen für Constraint-basiertes Pruning (wenn Constraint nicht anti-monoton) erklären können.
Welche zwei Sprachen haben wir für die Formulierung der Constraints kennengelernt?
Warum ist SQL nicht geeignet, um Constraints zu formulieren?
Clustering
BIRCH-Algorithmus: Wie kann man den Radius aus N, LS, SS herleiten?
BIRCH-Algorithmus: Wie kann man den Durchmesser aus N, LS, SS herleiten?
BIRCH-Algorithmus: Wie kann man die Interclusterdistanz aus N, LS, SS herleiten?
BIRCH-Algorithmus: Wie lassen sich die Clustering-Features eines zusammengefügten Clusters $C_{12} = C_1 \cup C_2$ aus den Komponenten berechnen?
Was spricht dagegen, $\mathbf{\varepsilon}$ in OPTICS riesig zu wählen?
Gegeben Szenario X, welche Clustering-Verfahren sind sinnvoll, und warum?
Warum funktionieren herkömmliche Clustering-Verfahren in hochdimensionalen Merkmalsräumen nicht? Skizzieren Sie eine mögliche Lösung.
- Erklären Sie, warum Clustering mit kategorischen Attributen besonders ist? Warum ist Link-basiertes Clustering hier hilfreich?
Bayes
- Gegeben ein beispielhafter Datenbestand, vergleichbar mit dem auf Folie 10, Vorhersage mit Naive Bayes erklären/vorführen können.
Was ändert sich, wenn die Attribute nicht voneinander unabhängig sind?
Material und Links
Die Vorlesung wurde gestreamt und ist unter mml-streamdb01.ira.uka.de verfügbar.
Literatur:
- Ian H. Witten, Eibe Frank: Data Mining. Practical Machine Learning Tools and Techniques.
- Harvey J. Miller, Jiawei Han: Geographic Data Mining and Knowledge Discovery (Clustering)
More:
Vorlesungsempfehlungen
Folgende Vorlesungen sind ähnlich:
- Analysetechniken großer Datenbestände
- Informationsfusion
- Machine Learning 1
- Machine Learning 2
- Mustererkennung
- Neuronale Netze
- Lokalisierung Mobiler Agenten
- Probabilistische Planung
Termine und Klausurablauf
Es ist noch nicht klar, ob es eine mündliche oder eine schriftliche Prüfung wird.
Falls es mündlich ist, soll es mindestens einen Termin pro Monat geben.
Datum: Noch ist es eine mündliche Prüfung
Ort: Noch ist es eine mündliche Prüfung
Punkte: Noch ist es eine mündliche Prüfung
Zeit: Noch ist es eine mündliche Prüfung
Punkteverteilung: Noch ist es eine mündliche Prüfung
Bestehensgrenze: Noch ist es eine mündliche Prüfung
Übungsschein: Gibt es nicht.
Bonuspunkte: Gibt es nicht.
Ergebnisse: Noch ist es eine mündliche Prüfung
Einsicht: Noch ist es eine mündliche Prüfung
Erlaubte Hilfsmittel: keine